
五大维度、12个语种,全第一!云知声U2-OCR登顶MDPBench榜单
欢迎订阅《信阳手机报》移动用户发送短信 XYSJB 到10658300即可开通 3元/月 不收GPRS流量费
文档智能的挑战,远不止识别文字。一张带有弯折、阴影的随手拍照片,一份采用不同文字系统的多语种资料,或一个文本、表格、公式交织的复杂页面,都要求模型在准确识别内容的同时,还原页面结构与阅读顺序,将文档转化为可利用的信息。
近日,云知声U2-OCR在多语言文档解析基准MDPBench中取得领先成绩:以86.0分登顶文档解析专业模型(Specialized VLM)榜单,并在全类别(All types)榜单中位列第二,超过Kimi K3等通用视觉语言模型。
在专业模型类别中,U2-OCR还包揽数字文档、拍照文档、拉丁文字系、非拉丁文字系及私有评测集五项细分维度第一,并在17个评测语种中取得12个语种单项第一。这一表现,体现了其跨语言、跨版式及复杂成像条件下的文档解析能力。
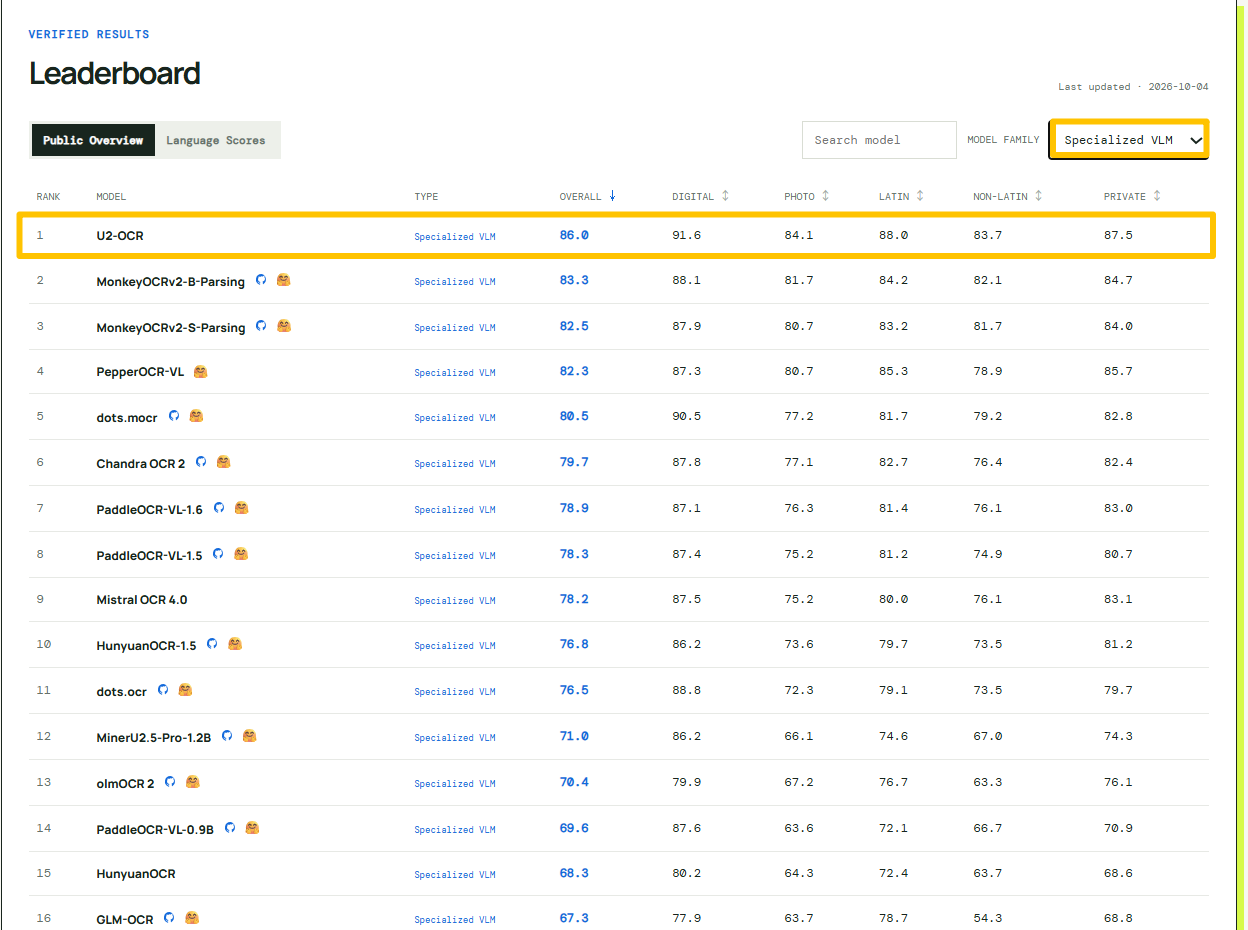
图1:MDPBench文档解析专业模型榜单(Specialized VLM)

图2:MDPBench全类别模型榜单(All types)
1 从综合领先到细分第一,U2-OCR能力覆盖多类文档场景
作为面向文档智能的OCR大模型,U2-OCR支持文档解析、信息抽取、视觉问答和文字定位。此次评测中,其领先表现覆盖了不同成像方式、文字系统与评测数据集。
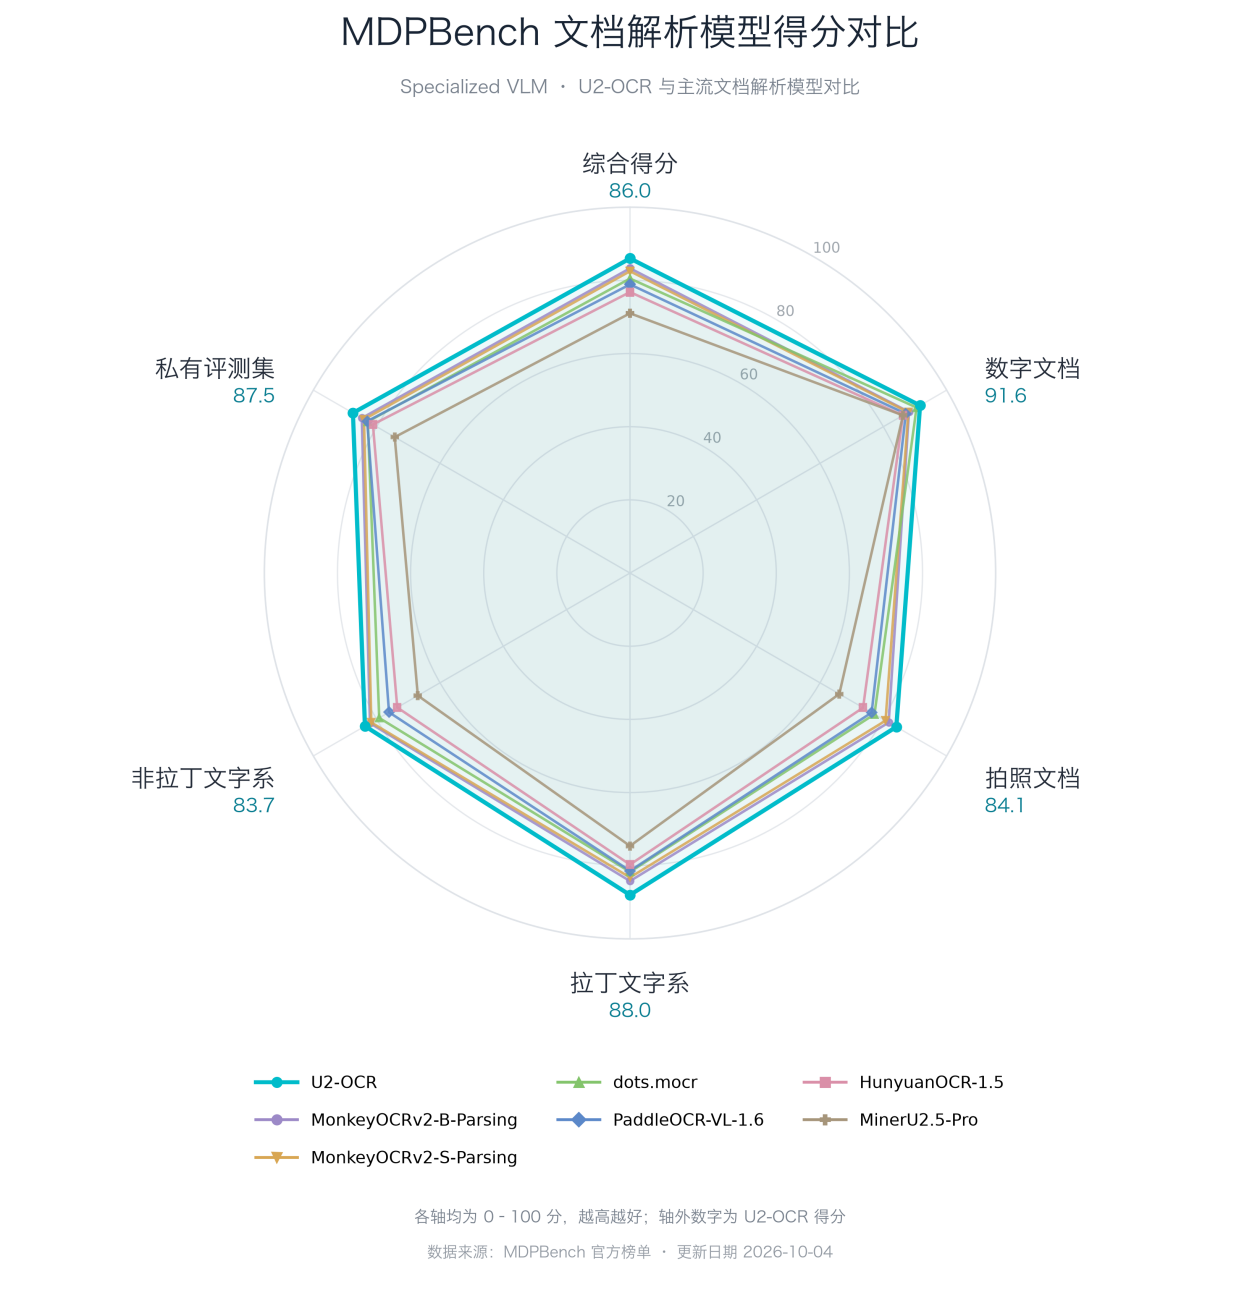
图3:U2-OCR五项细分维度成绩,排名范围均为Specialized VLM类别。
其中,拍照文档与非拉丁文字系统是MDPBench重点考察的挑战。U2-OCR在这两项中分别取得84.1分和83.7分,说明其优势不仅体现在清晰、规整的数字页面上,也延伸至更复杂的拍摄条件和文字系统。
私有评测集上的87.5分,则提供了进一步的验证。MDPBench包含2,720张公开评测图像与680张私有评测图像;私有图像及标注不公开,由官方组织评测,以降低针对公开样本定向优化带来的偏差。
在逐语种评测中,U2-OCR的领先表现同样具有广泛覆盖。在17个语种中,以下12个语种得分位列专业模型类别第一,占评测语种总数的七成以上。
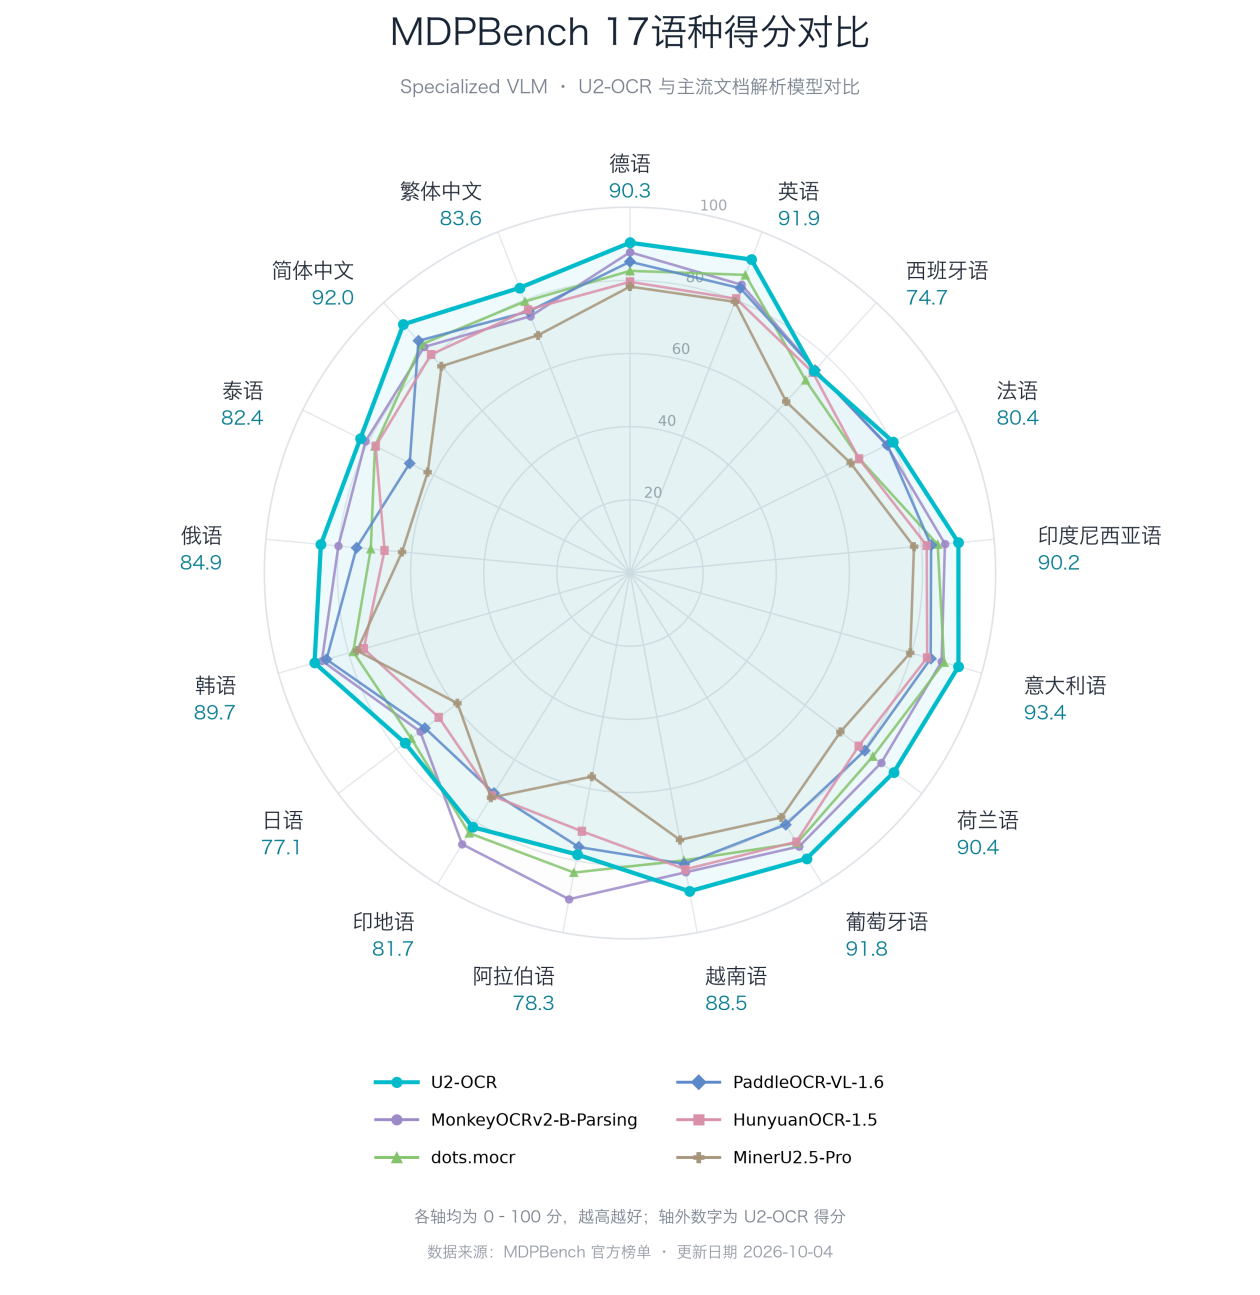
图4:U2-OCR在17个语种中取得12项第一,排名范围均为Specialized VLM类别。
从欧洲语言到东南亚语言,从中文到日语、俄语,U2-OCR在多个语种中取得领先成绩。这些结果表明,其优势并非仅集中在个别语言,而是在多语种文档解析评测中呈现出较为广泛的竞争力。
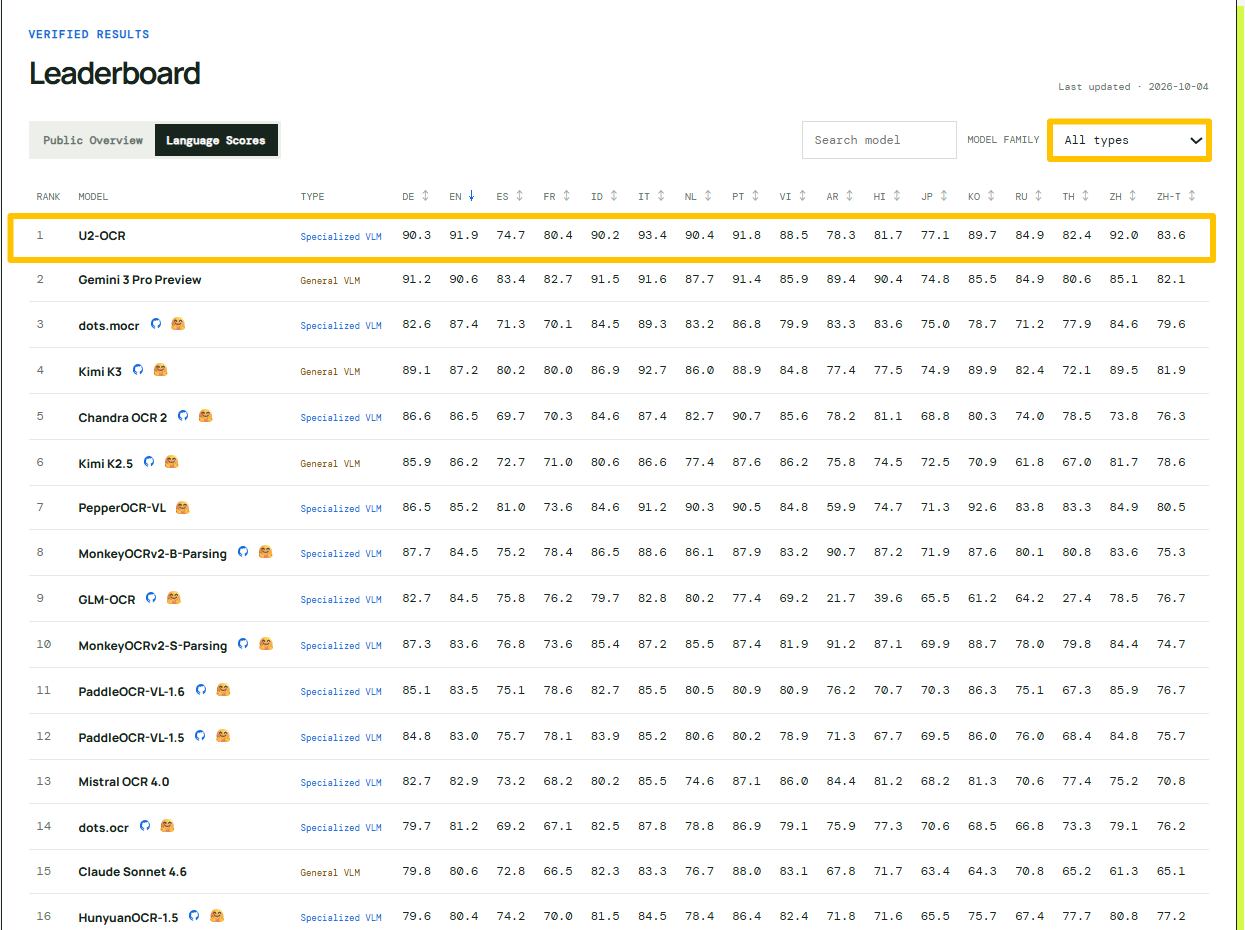
图5:MDPBench逐语种得分节选(Specialized VLM)
2 五项第一、12语种领先,优势不只在"容易的题"上
MDPBench覆盖17个语种、3,400张文档图像,其中75%为真实拍摄图像。模型不仅需要应对倾斜、弯折、反光与阴影等成像干扰,还要适应不同文字系统与阅读规则,准确还原文本、表格、公式及整页阅读顺序。在评测中,模型不会预先获知文档语种或成像类型,进一步考验其跨语言、跨版式与复杂拍摄条件下的解析能力。

图6:MDPBench真实拍摄样例——倾斜、弯折、褶皱、模糊与阴影等干扰可同时出现在一张图像中。
3 高质量数据池+分阶段训练,U2-OCR如何做到端到端解析
面对上述挑战,U2-OCR围绕数据质量、多任务训练和端到端解析构建技术能力,将通用文档理解与重点场景强化相结合。
高质量数据构建,为多任务学习打好基础。 U2-OCR围绕文档解析、信息抽取、视觉问答和文字定位,构建覆盖不同文档类型、版式结构及语言场景的训练数据体系。通过多模型预测结果交叉验证、格式校验、内容一致性检查与异常样本过滤,提升训练标签的准确性和可靠性;同时持续补充多语言、复杂表格与真实拍摄样本,形成万级文档解析训练数据池。
分阶段训练,强化多语言与真实拍摄能力。 U2-OCR首先通过解析、抽取、问答和定位任务的联合训练,建立通用文档理解能力;随后引入多语言解析与拍照文档专项数据,进一步学习不同语言的文字特征、阅读规则,以及复杂拍摄条件下的页面特征,增强跨语言、跨版式与非理想成像场景下的适应性。
端到端解析,将文档图像直接转化为可用内容。 在推理阶段,U2-OCR直接接收文档图像,在统一模型框架下完成文字识别、版面结构理解与结果生成,并根据任务需求输出Markdown解析结果或结构化信息。结合针对倾斜、褶皱、弯折与透视变形的专项训练,模型能够从复杂拍摄图像中提取内容与结构,保留文档原有的组织关系。
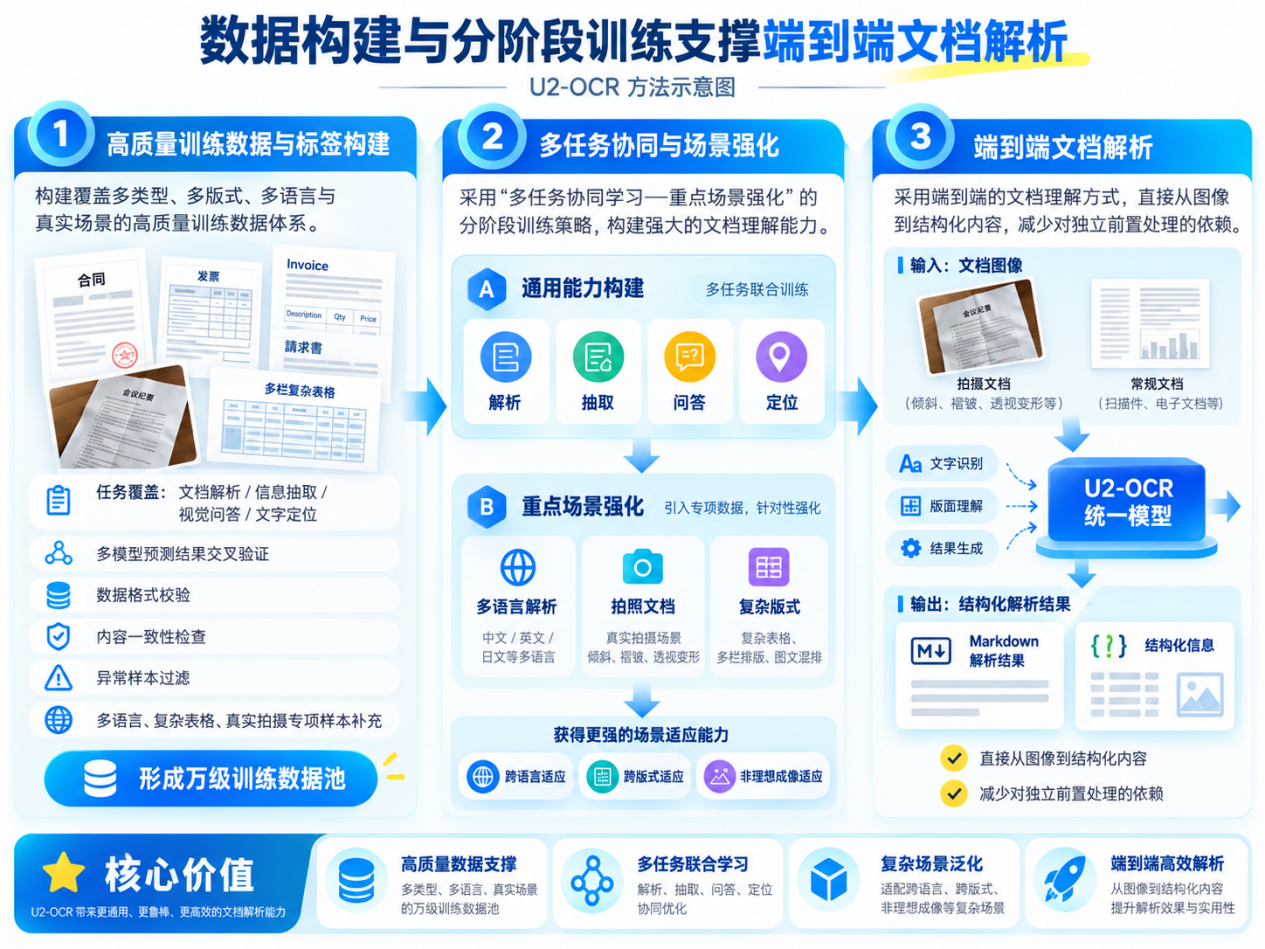
图7:U2-OCR 数据构建与分阶段训练支撑端到端文档解析
4 从榜单到业务:让"难啃的文档"不再依赖人工
从综合得分第一,到五项细分维度与12个语种全面领先,MDPBench的成绩验证了U2-OCR在多语言、复杂成像条件下的解析能力。
对业务而言,这意味着跨境单据、金融票据、拍照文档等长期依赖人工处理的场景,有了更可靠的自动化基础。
未来,云知声将持续推进OCR与多模态技术迭代,围绕多语种适配、拍照文档解析和结构还原打磨模型能力,让复杂文档中的信息更准确地被识别、理解与利用。
 文章投诉热线:156 0057 2229 文章投诉邮箱:291 3236@qq.com
标签:
 报晓风
 信阳日报微信
 掌上信阳微信
 信阳日报新浪微博
 信阳日报腾讯微博
请您文明上网、理性发言,并遵守相关规定。网友评论
网友评论仅供其表达个人看法,并不表明信阳新闻网立场。

